archive

Archives de Tag: Traitement automatique des langues

Bonjour à tous !

Je vais vous proposer une petite série d’interviews d’experts en ingénierie linguistique, qui pour moi, est complètement corrélée au SEO / référencement naturel ! J’ai l’honneur de commencer cette série avec Damien Nouvel, maître de conférences à l’INALCO, et qui allait devenir mon directeur de thèses (mais à la place, j’ai publié deux bouquins ! car on ne fait pas les choses à moitié ici ;)) !

C’est parti pour l’interview :

Présentation de l’expert TAListe :

Je suis maître de conférences à l’Inalco, membre du laboratoire ERTIM. J’y travaille dans le domaine du traitement automatique des langues (TAL), en particulier sur la fouille de données textuelles et le multilinguisme pour une large variété de langues (occidentales et orientales) et pour des objectifs variés (translittération, désambiguisation lexicale, opinion, analyse textométrique, etc.). J’ai précédemment travaillé au LIMSI-CNRS (extraction d’information), à INRIA Alpage (mots hors-vocabulaire dans les fils de dépêches). Ma thèse, faite dans l’équipe BDTLN du LI de Tours, a porté sur la reconnaissance automatique des entités nommées (disons les noms propres), par d’extraction automatique de motifs séquentiels (de la fouille de données).

Comment définirais-tu la notion de TF-IDF ?

Le TF-IDF est une méthode historique, fondée dans les années 80, pour implémenter des outils de recherche d’information. L’exemple typique est le moteur de recherche, qui doit sélectionner les documents les plus pertinents pour une requête donnée. Une simple recherche booléenne dans les index donne trop de résultats, qui ne sont pas ordonnés. L’algorithme TF-IDF pallie cela en exploitant simultanément le nombre d’occurrences des termes (TF) et leur importance sémantique dans la collection de documents (IDF) pour ordonner les résultats, et présenter en haut de la liste ceux qu’un calcul statistique simple nous indique être les plus pertinents. D’autres algorithmes sont aujourd’hui plus performants, mais celui-ci reste fondateur car il est très fiable, solide et stable : il peut être implémenté facilement et constitue un excellent point de départ.

tfidf-interview-damien-nouvel-autoveille

Et pour le Rappel et la Précision ?

Pour expliquer ces deux mesures de qualité de résultats (par exemple pour un moteur de recherche), il faut faire appel à deux notions complémentaires : le silence et le bruit. Le rappel indique à quel point un algorithme donne tous les résultats attendus, sinon on dit qu’il y a du silence. La précision calcul la proportion de résultats ramenés sont pertinents, ceux qui ne le sont pas donnent du bruit. Le défi, en particulier en recherche d’information, est de trouver le meilleur compromis possible : il faut à la fois améliorer la précision et le rappel, ou, dit autrement, réduire le bruit et le silence ! Pour mesurer cela globalement, il existe une troisième métrique qui combine le rappel et la précision, que l’on appelle la F-mesure, qui est la moyenne (harmonique) des deux précédentes. Ceci dit, dans le domaine de la recherche d’information, si ces mesures restent valables, elles sont aujourd’hui moins utilisées au profit d’autres métriques plus adaptées.

Dans quels cas utilises-tu le TF-IDF ? et pourquoi ?

Le TF-DIF est implémenté dans de très nombreux langages sous forme de librairies, il nécessite très peu de programmation pour son implémentation et des ressources limitées (temps de calcul ou mémoire) lors de son exécution. Il est robuste et stable. Ainsi, lorsque je travaille sur des projets pour lesquels j’ai besoin de résultats rapidement et pour lesquels les exigences ne pas trop fortes en terme de pertinence, le TF-IDF convient très bien… si les exigences sont plus fortes, il est possible de s’en servir comme point de référence avant d’utiliser d’autres modèles plus sophistiqués, comme par exemple le LSA.
Il faut cependant noter que le TF-IDF n’exploite que les textes des documents. Ceci peut-être un avantage pour les bases documentaires, mais un inconvénient si des liens sont faits entre les documents (sur le web, les hyperliens) : ils apportent une information très importante, qui ne sera pas prise en compte par TF-IDF.

Aurais-tu un exemple concret lié à l’usage du TF-IDF ?

Une entreprise vous sollicite pour mettre en place un moteur de recherche interne sur ses documents et l’intégrer à son portail. Elle ne sait quel moteur choisir, s’il lui faut une solution gratuite ou payante et quelles technologies sont adéquates. Vous pouvez alors facilement et rapidement lui proposer un développement préliminaire : mettre en place un TF-IDF, permettre aux utilisateur de faire leurs premières requêtes, avant d’analyser les limites de cette première approche. Par la suite, selon les retours, il pourra être prioritaire d’améliorer le moteur, mais peut-être aussi de travailler sur la qualité des documents, la création de ressources adéquates pour améliorer les recherche, la mise en place d’autres fonctionnalités, etc. !

Comment vois-tu l’avenir du TAL ?

Plusieurs pistes émergent aujourd’hui. Les dernières avancées côté recherche se sont beaucoup focalisées sur l’utilisation généralisée du Deep Learning, qui a de nombreuses applications et réduisent les difficultés à mettre en œuvre certains traitements, en particulier pour la sémantique. Les progrès en reconnaissance vocale et l’engouement récent pour les systèmes de dialogues (dont les chatbots / robots) sont également très en vue et vont certainement remodeler en profondeur le paysage du TAL, à l’international comme en France. Nous constatons également l’impact, parfois trop peu visible, des systèmes de génération automatique de contenus (dont textuel), autant sur les forums que dans les médias et les réseaux sociaux, il faut être vigilant à cet égard, être conscient des limites et des risques, les utiliser à bon escient ! En lien avec cela, je me penche ces derniers temps sur la détection et la caractérisation des Fake News, qui représente à mes yeux un enjeu scientifique et sociétal majeur, nous allons d’ailleurs organiser un hackathon sur le sujet en mai.
Sur le fond, et comme je le dis souvent aux étudiants, il me semble que le TAL doit rester une discipline qui “permette aux humains de manipuler le langage par d’autres moyens et à une autre échelle”. Il est essentiel à mes yeux que les outils, ressources et technologies que nous développons restent au service du plus grand nombre !

Merci infiniment à Damien Nouvel d’avoir accepté de répondre à cette interview hyper enrichissante !

J’espère que vous comprenez mieux l’intérêt du TAL maintenant, et pourquoi je vous rabâche avec cela dans le monde du SEO 😉 C’est complétement lié !

Bon courage à tous,

Véronique Duong – Directrice associée chez Rankwell et consultante SEO certifiée CESEO !

Bonjour tout le monde !

Quand j’étais étudiante en ingénierie linguistique, on a eu des cours et des projets pour nous apprendre à construire des ontologies sémantiques pour un domaine donné.

On travaillait beaucoup sur de la terminologie et de l’analyse sémantique. J’aimais beaucoup ça, et c’est vrai que grâce au SEO, je refais parfois des ontologies, c’est-à-dire des graphes représentant des relations sémantiques. Cela ressemble à ça :

Ontologie - Graphe relations sémantique - AUTOVEILLE

Source : http://theses.ulaval.ca/archimede/fichiers/24629/24629_9.png

En SEO, on part aussi du plus générique au plus spécifique. Quand je dois établir une étude de mots-clés pour un site, je pars de son menu (souvent il contient les termes plus génériques), et plus on va en catégories et sous-catégories, plus on aura des choses spécifiques. Par exemple, pour un site sur les VTT, on peut avoir une ontologie sémantique comme celle-ci qui est assez bien détaillée :

ontologie-vduong-web-semantique-VTT

Source : http://www.referencement-naturel-white-hat.fr/images/cocon-semantique-type.png

Cela permet de relier toutes les pages entre elles, et d’avoir un super maillage interne aussi !

Si vous n’avez pas fait ce travail de relation sémantique entre vos pages, vous pourriez commencer à y songer car c’est important pour les utilisateurs (thématiques précises) comme pour les moteurs de recherche. Un tel maillage sémantique entre vos pages va vous permettre d’atteindre des scores sémantiques beaucoup plus intéressants. Pour trouver les mots-clés spécifiques, j’utilise le Keyword Planner.

Si vous voulez savoir la formation que j’ai faite en Master, c’est le Master Conception de Documentation Multilingue et Multimédia et le Master Ingénierie Linguistique

Une question ? écrivez moi à autoveille@gmail.com ou vduong@rankwell.fr

Bon courage à tous !

Véronique Duong – Consultante SEO certifiée CESEO 2014  et Ingénieure Linguiste (de formation)

Bonjour tout le monde !

Comme vous le savez tous, de formation, je suis ingénieure linguiste, et je suis autant passionnée par le TAL que par le SEO. Je dirais toujours que c’est le TAL qui m’a menée vers le SEO car j’ai vu le lien entre ces deux domaines dès le début : Linguistique x Informatique en TAL, et Sémantique x Technique en SEO. Je me définirais toujours comme une spécialiste du SEO et du Traitement Automatique des Langues. Il y a moins d’événements sur le TAL que le SEO, et je trouve cela extrêmement dommage car le TAL, la science du langage a tout le mérite de se faire connaître.

En TAL, on produit des outils, des scripts qui servent, qui sont utiles pour des expériences scientifiques, et cela permet de faire progresser la R&D pour beaucoup de choses. Typiquement, j’utilise mes compétences en TAL pour automatiser certaines phases super chronophages (nettoyage des textes, optimisation des méta tags, etc.). autant que possible.

Pendant ce HackaTAL 2017 qui s’est déroulé à Orléans, au Lab’O (incubateur de start-ups dans le numérique), on a eu droit à quelques petites conférences d’entreprises spécialisées dans le TAL, telles que Recital (génération de résumé automatique), Mood Messenger, etc.

On avait des tâches très précises à réaliser, et voici les consignes officielles :

Tâches

1. Résumé automatique de commentaires sur des produits en ligne

Objectifs

Dans le cadre de la promotion de produits sur les plateformes en ligne, l’appréciation peut être analysée à partir des retours utilisateurs (User Generated Content). Ces derniers peuvent se présenter : notes, étoiles, mais aussi avis et commentaires textuels. Les notes n’étant pas toujours en adéquation avec les contenus textuels, de plus en plus d’acteurs cherchent à qualifier l’opinion des utilisateurs et à déterminer quels sont leurs arguments.

La thématique est orientée sur les avis et commentaires concernant l’offre de logements en région centre (particuliers, auberges, hôtels, luxe, etc.). Il s’agira de construire un résumé automatique des commentaires, à partir des arguments détectés dans ces derniers, à comparer aux notes et/ou à la description. Ce résumé orienté devra être séparé en deux champs principaux : points positifs et points négatifs sur des critères communs : accueil, confort, services, propreté, accessibilité, etc. D’autres champs peuvent être proposés par les participants selon les arguments extraits à partir des commentaires.

Sous tâches

  • Traitement / débruitage de données UGC
  • Détection et extraction d’arguments
  • Agrégation des valeurs par produits
  • Détection et résolution de contradictions
  • Résumé automatique d’opinions sur les aspects

Données et évaluation

Collection de données représentant chaque produit en ligne (champs de description du produit, notes ou étoiles, liste des commentaires associés) en français et en anglais. Les données seront fournies sous-forme de corpus (pour le corpus collecté sur Internet) et/ou via des liens à télécharger (pour les données fournies par les partenaires, à préciser).

L’évaluation portera sur la capacité à calculer automatiquement les scores pour chaque catégorie d’évaluation du produit (accueil, propreté, emplacement, etc.). Pour chacun de ces scores, un argumentaire résumé automatiquement devra être fourni qui pourra faire l’objet d’évaluation qualitatives.

2. Identification des tendances stratégiques liées aux brevets

Objectifs

La stratégie de dépôt de brevets par des entreprises ou des individus représente un enjeu considérable, qui a donné lieu à des affaires mondialement connues (Apple vs Samsung, Microsoft vs Google). Cet outil juridique reste cependant difficilement accessible pour les entreprises de petite taille ou les individus. En particulier, il n’est pas évident de déterminer quelles technologies vont avoir tendance à être l’objet de brevets, dans une optique de veille ou de préservation de la propriété intellectuelle.

La tâche proposée vise à mieux modéliser les mécanismes qui permettent de prédire l’apparition de brevets pour des technologies en essor, par utilisation de méthodes d’IA et de TAL (terminologie et expressions multi-mots, catégorisation des brevets, évolution des termes et des n-grams, prédiction de tendances). L’objectif est de déterminer, au regard des données collectées sur des brevets (par ex. distribution des termes entre 2001 et 2009), quels brevets seront déposés (par ex. en 2010). Pour illustration : si “tactile” est recensé avec une grande montée en 2010, pouvait-on prédire cette montée en exploitant les données de la décennie précédente ?

Sous tâches

  • Prétraitement du langage et de la structure des brevets
  • Extraction de terminologies liées aux technologies
  • Comparaison des termes des brevets avec les sites technologiques
  • Détection de signaux faibles
  • Analyse et prédiction de tendances

De mon côté, je me suis penchée sur le résumé automatique de commentaires sur des produits en ligne. J’ai déjà eu des sujets similaires à traiter, et je trouve cela plus concret et utilisable tout de suite derrière (une fois que le script est prêt, l’outil peut servir !! 🙂 ) On était une équipe de 3 : deux développeurs web et moi. La technologie utilisée était du PHP, des Regex, de l’étiquetage de données, et la stratégie était d’utiliser les mots ayant le plus de poids dans une phrase (adverbe, adjectifs, verbes). Avec cette méthode, on a eu un Rappel de près de 80% ! (Rappel = le nombre de documents correctement retrouvé dans sa classe, Précision = le nombre de documents correctement attribué dans sa classe (ex : pour le rappel, cela veut dire que le commentaire a bien été retrouvé dans telle ou telle catégorie automatiquement, et la précision correspond au fait si le commentaire est bien attribué positif / neutre / négatif).

C’est mon équipe qui a gagné le HackaTAL 2017 !!! Je suis très contente que ma stratégie / réflexion marche (avec les ADJ, les ADV, etc.), et on s’est bien débrouillé avec les développeurs ! Un Grand MERCI à Nicolas Le Flohic et Fanny Jan, mes co-équipiers.

hackatal 2017 - équipe Wild gagnante

Voici quelques clichés du HackaTAL 2017 :

La jolie photo de souvenirs devant le logo du Lab’O !

Présentations des projets de chaque équipe :

Ca code, ça code !! Près de 48 heures de scripting 😉

https://twitter.com/eldams/status/878903996307693569

https://twitter.com/eldams/status/878902768886579200

Toutes les équipes ont bien travaillées, et ce sont données à 200% !!! Un week-end intense avec de belles rencontres, des échanges hyper intéressants, et … cela m’a redonnée une folle envie de me remettre dans le TAL !!

En tout cas, une chose est sûr, la Science du Langage est une science qui a beaucoup d’avenir :

Je pense qu’il y a moyen qu’un jour, je retourne à 100% dans les Sciences du Langage, dans le Traitement Automatique des Langues. On verra ce que la vie me donnera !

J’espère que cet article vous aura plu, il change un peu du SEO 😉

Un énorme merci à Damien Nouvel (ERTIM / INALCO), au Lab’O et tous ceux qui ont organisé cet superbe événement concret et intense !

Bon courage à tous,

Véronique Duong – Ingénieure Linguiste … avant tout 🙂 !

Bonjour tout le monde !

Je ne pensais jamais vous parler du langage R sur ce blog ! Pour moi, R était un outil que j’ai utilisé en Master 2 d’Ingénierie Linguistique, et que je ne m’en servirais pas pour le SEO ou le monde professionnel … eh bah non ! R est un outil pour calculer, gérer les statistiques, et il s’avère très puissant et plus flexible que certains outils sur le marché !

J’ai mis en place une petite veille informationnelle pour voir les publications qui remontent sur R, et mon logiciel de veille a crawlé une infographie sur les caractéristiques de R, et ça tombe parfaitement bien. L’illustration est signée IntelliPaat (agence digitale de big data et de e-learning indienne).

Pourquoi faut-il utiliser le langage R ?

  1. C’est Open-source et le logiciel couvre un large éventail de calculs statistiques
  2. Comparable et même supérieur à certains outils payants sur le marché
  3. Disponible pour Windows, Linux et Mac
  4. En plus des opérations statistiques, c’est une Konsole, donc un outil de programmation, qui automatise vos analyses et qui crée de nouvelles fonctions
  5. Structure de programmation orientée objet (POO)
  6. Les données sont enregistrées par session, donc pas besoin de les ressaisir à chaque fois
  7. Comme c’est un outil open-source, il y a une vague communauté de statisticiens qui l’utilisent et qui sont prêts à vous aider

Voici l’infographie en question :

Langage R : les caractéristiques - SEO - AUTOVEILLE

J’ai retrouvé mes cours de M2 sur R, et on s’en servait surtout pour calculer la fréquence des mots-clés dans des corpus, on faisait des matrices, des graphes, etc. Voici un petit extrait d’un de mes exercices à l’époque :

Langage R - Statistiques textuelles - AUTOVEILLE

Cela fait 5 ans que je n’en ai pas fait, mais je vais m’y remettre ! C’est un langage que je connais, et je ne veux pas laisser passer cette opportunité ! 🙂

Et vous ? programmez-vous en R ?

Si vous avez la moindre question sur le traitement automatique des langues, le SEO, l’automatisation de la veille stratégique, etc. écrivez-moi à autoveille@gmail.com

Bon courage à tous !

Véronique Duong – Consultante SEO certifiée CESEO


Bonjour à tous,

Dans l’article d’aujourd’hui, nous nous intéressons aux systèmes et aux méthodes d’indexation et de référencement de Google. En effectuant une veille stratégique sur les algorithmes de Google, mon logiciel de veille m’a rapatrié un article très intéressant portant sur le fonctionnement des crawlers et des différents autres composants de Google. Cet article a été rédigé par les deux fondateurs de Google, Sergey Brin et Larry Page. Vous pouvez lire cet article en suivant le lien sur le site de Stanford.edu

Même si les algorithmes du moteur sont confidentiels, grâce au schéma fourni dans l’article, on peut tout de même mieux comprendre comment marche l’indexation chez Google. Dans le livre d’Olivier Andrieu, on peut lire que Google posséderait deux index : un index principal (où il faut absolument y être pour être visible) et un index secondaire (pages dupliquées, pages ayant peu de liens externes, pages « mal liées », etc.).

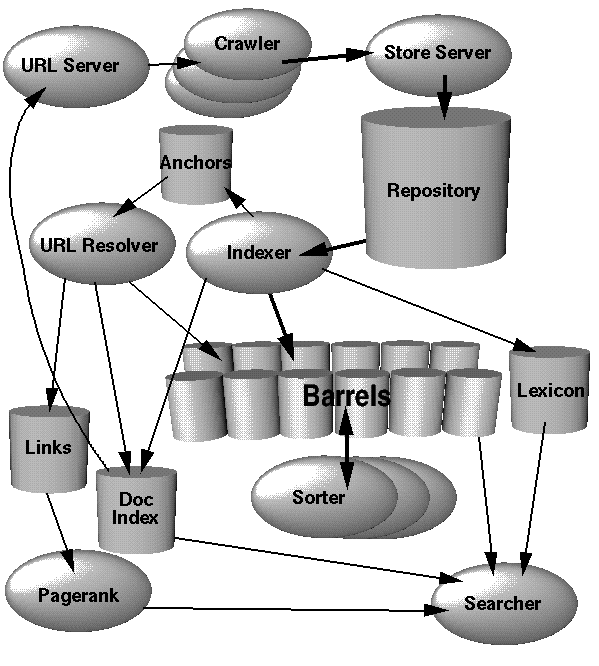
Voici l’architecture « high level » (comme le décrit les fondateurs) de Google :

Architecture des composants de Google - AUTOVEILLE


Source : Stanford (Article rédigé par Sergey Brin et Larry Page)

Voici ce que les fondateurs expliquent par rapport à cette structure [Extrait de l’article] :

In Google, the web crawling (downloading of web pages) is done by several distributed crawlers. There is a URLserver that sends lists of URLs to be fetched to the crawlers. The web pages that are fetched are then sent to the storeserver. The storeserver then compresses and stores the web pages into a repository. Every web page has an associated ID number called a docID which is assigned whenever a new URL is parsed out of a web page. The indexing function is performed by the indexer and the sorter. The indexer performs a number of functions. It reads the repository, uncompresses the documents, and parses them. Each document is converted into a set of word occurrences called hits. The hits record the word, position in document, an approximation of font size, and capitalization. The indexer distributes these hits into a set of « barrels », creating a partially sorted forward index. The indexer performs another important function. It parses out all the links in every web page and stores important information about them in an anchors file. This file contains enough information to determine where each link points from and to, and the text of the link.

The URLresolver reads the anchors file and converts relative URLs into absolute URLs and in turn into docIDs. It puts the anchor text into the forward index, associated with the docID that the anchor points to. It also generates a database of links which are pairs of docIDs. The links database is used to compute PageRanks for all the documents. […]

Pour résumer en français, le crawling est effectué par différents robots. Il y a un « URLserver » qui envoie une liste d’URLs à extraire aux crawlers. Ces URLs seront ensuite envoyées dans le « storeserver ». Puis le storeserver compresses et stockes les pages web (URLs) dans un « entrepôt ». Chaque page a un ID nommé docID qui lui est assignée.

L’index fonctionne grâce à deux composants : l' »indexer » et le « sorter » (outils d’indexation et de tri). L’indexer possède plusieurs fonctions. Il lit les éléments dans l’entrepôt, décompresse les documents et les décrypte. Chaque document est découpé en mots nommés « hits ». L’indexer met ces « hits » dans des silos (« barrels »), ce qui crée des index partiellement triés. L’indexer analyse tous les liens d’une page et stocke les ancres dans un fichier nommé « anchors ». Ce fichier contient des informations qui indiquent d’où provient un lien et le texte sur ce lien (l’ancre).

L’URLresolver lit les fichiers d’ancres et convertit les liens relatifs en liens absolus qui sont ensuite transformés en docIDs. Cela met l’ancre de texte dans l’index transféré, associé au docID dont l’ancre y pointe. Cela génère également une base de données de liens qui est utilisée pour calculer le PageRank de chaque page … 🙂

Grâce à cet article, on comprend bien mieux comment Google fonctionne. Il n’y a pas qu’un outil, qu’un seul algorithme, mais plusieurs qui tournent en même temps. Panda, Penguin, etc. ne seraient rien d’autres que des composants qui font partie de la chaîne de traitements maintenant.  Je n’ai traduit que l’essentiel de l’article car c’est la partie la plus intéressante pour comprendre le SEO à mon avis. En voyant le schéma, c’est typiquement une chaîne de traitements d’ingénierie linguistique informatique très poussée. Peu à peu, je vais me remettre dans les recherches scientifiques car j’aime beaucoup étudier les problématiques liées à ce domaine.

Si vous avez des questions sur le traitement automatique des données ou le référencement naturel, n’hésitez pas à me contacter avec cette adresse autoveille@gmail.com

Bon courage à tous !

Véronique Duong –

Bonjour tout le monde !

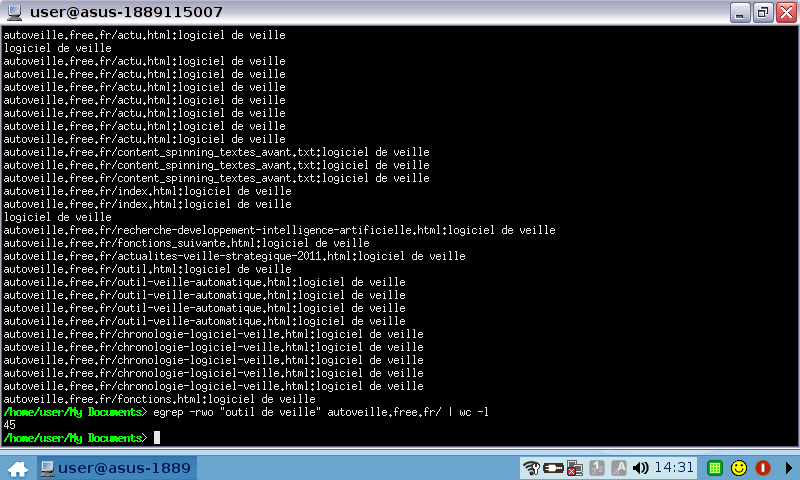
Malgré le rush au bureau, j’ai trouvé 10 minutes pour rédiger cet article sur un petit outil SEO automatique que je viens de développer avec avec les technologies de l’ingénierie linguistique qui tournent sous Linux Xandros. D’habitude, j’utilise Kubuntu ou Ubuntu. Mais comme je viens de découvrir le terminal de mon mini PC hier soir, j’en ai profité pour programmer dessus 🙂

Linux Xandros - Shell - Outil SEO - AUTOVEILLEGrâce à cet outil de calcul de densité de mots-clés, je peux rapidement voir la fréquence d’apparition d’un mot-clé dans l’ensemble des pages d’un site. Par exemple, avec le mot-clé « outil de veille« , j’ai trouvé 45 occurences de « outil de veille« .

Cette technique SEO permet de voir si le site assez de mots-clés par rapport au nombre de pages, et de voir s’il est bien optimisé (sous-optimisé ou sur-optimisé). Comme mon site est petit, il est bien optimisé sur le mot-clé « outil de veille » (une fréquence d’apparition de 45 pour 20 pages web, c’est OK).

Si vous voulez que j’extrais le nombre de mots-clés que vous avez dans votre site web, n’hésitez pas à m’écrire pour faire un petit test. Mon mail est désormais : autoveille@gmail.com (pensez à joindre l’adresse de votre site web et une petite liste de 5 à 10 mots-clés pour le test).

Bon courage à tous !

Véronique Duong –


Bonjour tout le monde !

Je vous propose ce nouvel article suite à la découverte d’une infographie super intéressante lors de  ma veille stratégique d’informations SEO / SMO / SEM. Mon logiciel de veille a en effet récupéré une illustration expliquant comment fonctionnerait Google (crawl, indexation, l’envoi d’une requête des internautes dans sa base de données, matching (= correspondance), etc.).

Elle est très complète à mon avis, et les étapes sont très détaillées. Elle a été réalisée par PPC Blog. L’auteur parle du crawl, de l’indexation, tout en passant par les filtres (déployés en fonction des mots-clés, requêtes, synonymes, etc.) probablement utilisés par le moteur de recherche américain.

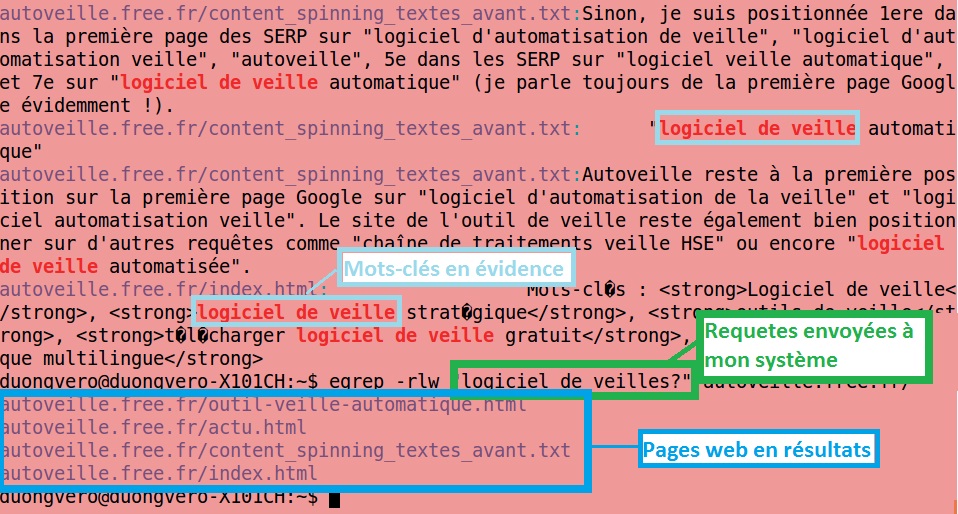
Il y a quelques temps, j’avais émis des hypothèses sur le fonctionnement possible des moteurs de recherche, et je pense que cette infographie complète ma recherche. Le moteur crawl et indexe des milliers de pages web, et selon les mots-clés saisis par les internautes qui ont été passé dans les différents filtres (cela me rappelle beaucoup la partie avec egrep dans mon étude), il affiche les résultats dans ses SERP.

Voici l’infographie, zoomez au maximum pour qu’elle soit lisible :

Comment fonctionne Google ? - par AUTOVEILLE

Gardez cette infographie quelque part car je pense qu’elle pourrait être très utile pour illustrer certaines études.

Qu’en pensez-vous de cette infographie ? N’hésitez pas à laisser vos avis et vos points de vue.

Bon courage à tous !

Véronique Duong –

Bonjour tout le monde !

Aujourd’hui, je vous ai préparé un article qui va toucher deux disciplines qui sont étroitement corrélées, à savoir le traitement automatique des langues (ou ingénierie linguistique) et le référencement naturel (ou SEO).

Ce que vous allez lire par la suite ne sont que des hypothèses car je ne connais pas l’algorithme de Google, mais après de nombreux tests, je trouve qu’il y a de (fortes) similitudes qui existent entre la méthode que j’utilise pour retrouver des pages web ou des fichiers dans mon système et celle du moteur de Google.

En effet, j’utilise souvent l’aspiration de sites web pour stocker les pages web qui m’intéressent, et pour en retrouver certaines, j’utilise des mots-clés … comme des requêtes que les internautes taperaient sur Google !

Voici l’exemple de mon propre site ci-dessous. Comme vous pouvez le voir, les pages web / HTML, les images, les autres fichiers sont tous crawlés par mon logiciel de crawling (qui n’est autre que mon logiciel de veille détourné en outil de crawl) :

base de données AUTOVEILLE |Logiciel de veille


Ensuite, pour trier les pages HTML que j’ai dans ma base ci-dessus, je lance une requête (encadrée en vert) de ce genre dans ma Konsole :

résultats de recherche egrep AUTOVEILLE


Je pense que Google posséderait une base de données gigantesque au vu du nombre de pages web qui existent, et des milliers de corpus thématiques / catégoriques. A chaque requête tapée, Google essayerait de fournir la meilleure réponse à l’utilisateur parmi ses trilliards de pages HTML 🙂

Je précise également que mon outil de crawl / de veille ne lit et ne crawl pas les images, le JavaScript. En tout cas, il y a des choses extrêmement corrélées entre le TAL et le SEO, et je m’éclate en faisant des recherches, des tests dans ces deux domaines ! 🙂

Très prochainement, je vous montrerai comment faire du content spinning propre !

Bon courage à tous,

Véronique Duong –

Bonjour tout le monde !

Ok, mon article commence par un titre relevant du jargon du traitement automatique des langues et de la fouille de textes. Vous devez vous dire « euh ok, et c’est quoi le TF-IDF ? », « qu’est ce que ça à voir avec le SEO ? » … Eh bien, je vais essayer de définir le TF-IDF en deux lignes avec des termes vulgarisés pour que vous comprenez :

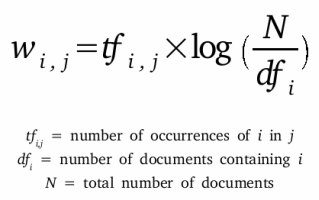
Le TF-IDF (qui est le sigle de Term Frequency-Inverse Document Frequency) est une mesure statistique qui permet d’évaluer l’importance d’un terme contenu dans un document ou dans un ensemble de textes. Il varie en fonction de la fréquence d’apparition du mot-clé dans le corpus.

Des variantes de la formule originale sont souvent utilisées dans des moteurs de recherche pour apprécier la pertinence d’un document en fonction des critères de recherche de l’utilisateur. (Source : Wikipédia)

Voici la formule de calcul (ça semble assez abstrait … je sais) :

Formule calcul du TF-IDF

En gros, plus un mot-clé est présent dans un document ou dans un corpus ( = base de données de textes), plus le TF-IDF sera élevé pour ce mot. Baidu utiliserait cette technologie pour faire la correspondance entre les mots-clés d’une requête d’un internaute et les documents dans sa base (dans son moteur). Ainsi, il afficherait les pages HTML qui auraient le plus de pertinence par rapport aux mots-clés de la recherche. (Source de l’article TF-IDF框架与SEO衍生)

Nuage de mots-clés AUTOVEILLE

Apparemment, Google et Yahoo! utiliseraient aussi la formule du TF-IDF pour afficher les résultats de recherche selon les requêtes des utilisateurs. Donc, il ne faudrait plus se contenter d’optimiser certaines parties (ex : juste les méta tags) d’une page, mais vraiment toute la page web (des méta tags au contenu textuel) en pensant à la notion de la densité de mots-clés.

Personnellement, j’utilise un script Perl pour faire le calcul du TF-IDF.

Voici une exemple plus concret de calcul de TF-IDF pour plus de clarté (tiré directement de Wikipédia) :

Calcul TF-IDF pour le SEO - AUTOVEILLE

Bon courage à tous,

Véronique Duong –

Bonjour à tous !

Je vous ai préparé un petit article sur le calcul automatique de la fréquence d’une occurence dans un corpus de textes ou … tout simplement d’une page web pour effectuer une analyse des mots-clés.

L’outil de calcul, que j’ai implémenté, ressemble quelque peu au Keyword Analysis Tool

Ce petit robot a été scripté en Perl. Il permet de découper un corpus de textes en mot et d’indiquer la fréquence (statistiques textuelles) de chaque forme présente dans le contenu.

Mon outil met environ 1 à 2 secondes pour découper le texte. Très rapide, non ? 🙂

Voici à quoi ressemble le script:

Outil d'analyse de mots-clés

Après avoir passé ce script sur un corpus de textes, on obtient des données statistiques, montrant le nombre de fois qu’une forme apparaît, comme celles-ci:

Fréquence de mots-clés et statistiques textuellesSi vous souhaitez en savoir plus, je vous invite à vous rendre sur le site AUTOVEILLE pour avoir plus d’informations. Sinon, posez-moi des questions via autoveille@gmail.com

Bon courage !

Véronique Duong –